1 Şubat 2017 Çarşamba

Hadoop'a Giriş

Hadoop:

  • Apache'inin açık kaynaklı bir kütüphanesidir. 
  • İşlem hacmi büyük olan verileri depolamak ve analiz etmek için kullanılır
  • Java dili ile yazılmıştır.
  • Sıradan sunuculardan(commodit hardware) oluşan küme(cluster) üzerinde büyük verileri işlemeye yarar.
  • HDFS, Hadoop Common, Hadoop Yarn ve Hadoop MapReduce bileşenleri tarafından oluşan bir yazılımdır.

Hadoop'un Modülleri


  • HDFS(Hadoop Distributed File System)(Storage Layer): Hadoop cluster'larındaki verilere yüksek performanslı erişim sağlalayan dağıtılmış bir dosya sistemidir.  HDFS, master/slave mimarisi kullanır. Master, dosya sistemin metadata'sını yöneten tek bir NameNode'dan oluşur. Gerçek data'yı depolayan bir veya birden fazla slave, DataNodes. HDFS alanında bir dosya,  birkaç bloğa bölünür ve blok'lar bir  DataNode kümesinde depolanır. NameNode, blokların DataNode'lara eşleşmesini belirler. DataNode, dosya sistemi ile okuma ve yazma işlemlerini yapar. Ayrıca, NameNode'lar tarafından verilen talimatlara göre blok oluşturma, silme ve replikasyon konuları ile de ilgilenir. HDFS, diğer bir dosya sistemi gibi bir shell komutu kullanır ve dosya sistemi ile etkileşim sağlamak için komutlar listesi mevcuttur. 
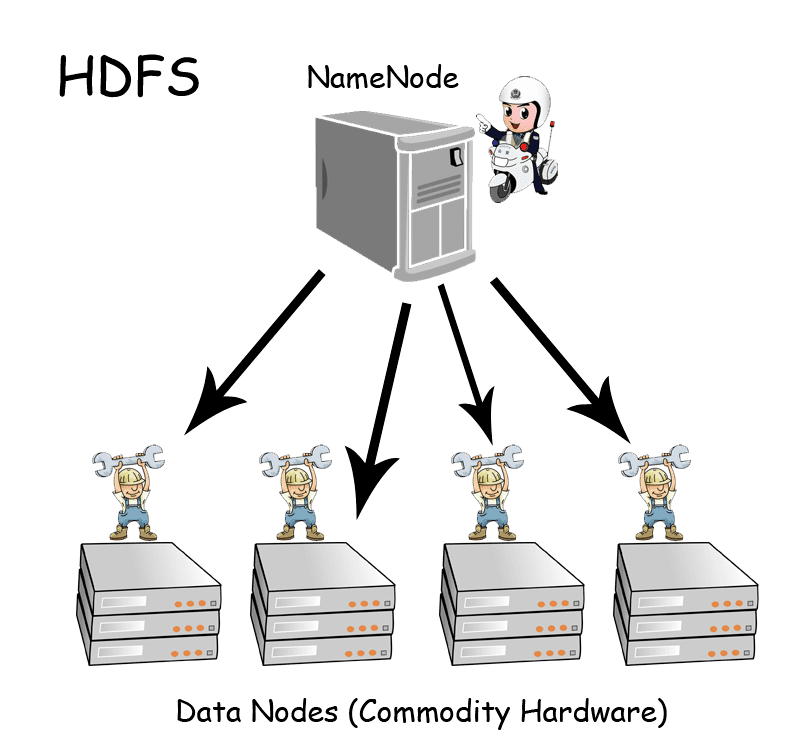
    • Hadoop Yarn(Yet Another Resource Negotiator): Verileri tutan kümedeki işleri planlanlamak ve kaynak yönetimi sağlamak için bir yapı sağlar.
    • Hadoop MapReduce (Processing and Computation Layer): HDFS üzerindeki büyük verileri işlemek için kullanılan bir yöntemdir. İstediğinizi verileri filtrelemek için kullanılan Map fonksiyonu ve verilerden sonuç elde etmenizi sağlayan Reduce fonksiyonlarında oluşan program yazıldıktan sonra Hadoop üzerinde çalıştırılır. Hadoop Map ve Reduce'lerden oluşan iş parçacıklarını küme üzerinde dağıtarak aynı anda işlenmesini ve bu işler sonucunda oluşan verileri tekrar bir araya getirilmesinde sorumludur. 

    MapReduce terimi, aslında  Hadoop programlarını gerçekleştirdiği aşağıdaki 2 farklı task'ı ifade eder.
      • Map Task: İnput veriyi alır ve bir veri kümesine dönüştürür.

      • Reduce Task:Bu task'ta,  map task çıktısı girdi olarak alınır. Bu veri tuple(row)'larını daha küçük bir tuple grubunda birleştirir. Reduce task, her zaman, map task'ından sonra yapılır.

    Client Machine: Ne NameNode ne de DataNode'tur. Client machine üzerinde Hadoop yüklü olan bir makinedir.  MapReduce işlerini submit(göndermek) etmek ve tamamlandıktan sonra görüntülemek.

    JobTracker, yazılan MapReduce programının cluster üzerinde çalıştırılmasından sorumludur. Ayrıca dağıtılan iş parçacıklarının çalıştırılması sırasında oluşabilecek herhangi bir problemde o iş parçacığını sonlandırılması ya da yeniden başlatılmasından sorumludur. TaskTracker,  DataNode'ların bulunduğu sunucuda çalışır ve JobTracker'dan tamamlamak üzere  iş talep eder. JobTracker, NameNode'un yardımıyla DataNode'un local diskindeki veriye göre en uygun Map işini TaskTracker'a verir. Bu şekilde verilen iş parçacıkları tamamlanır ve sonuç çıktısı yine HDFS üzerinde bir dosya olarak yazılarak program sonlanır.

    • Hadoop Common: Bazı  modüllerin Hadoop'a erişebilmesi için gerekli olan kütüphaneleri sağlar. Mesela Hive yada HBase, HDFS'e erişmek için bu kütüphaneleri kullanılır. Bu java kütüphanesi Hadoop'u başlatmak için kullanılır. Cluster'a veri yüklemekle sorumludur.

    Hadoop Ecosystem


    • Oozie:Bütün işleri shcedule etmek için kullanılan bir tool'dur.
    • Sqoop:Klasik veritabanı ile HDFS arasında toplu veri transferi yapmayı sağlayan bir tool'dur.

    • Zookeeper:İşlerin sürekli çalışır halde kalmasını sağlayan bir takip sistemidir.
    • Oozie:Bütün işleri schedule etmek için kullanılan bir tool'dur. 

    • HBase:Dağıtık temelli kolon bazlı bir veritabanıdır.
    • Hive:Dağıtık yapılı bir veri ambarıdır. Sql benzeri bir dil sağlar.
    • Pig:Veri akışını kontrol eden ve büyük boyutlu verilerde işlem yapmayı kolaylaştıran bir tool'dur. HDFS ve MapReduce cluster'larında çalışır.
    • MapReduce:Yukarıda anlatılmıştır.
    • HDFS:Yukarıda anlatılmıştır.
    • Flume:Hadoop'a aktarılacak dosyaların(log datası, ftp dataları, twitter datası vs) toplanması ve aggregate edilmesi ve taşınmasını sağlayan bir java uygulamasıdır. Bu java uygulamasına'da agent denilmektedir.


    29 Ocak 2017 Pazar

    Oracle Data Integrator(ODI) Kavramları


    Soru    1 :ODI(Oracle Data Integrator) Nedir.
    Cevap 1 :Farklı sistemler arasında yüksek hızda veri taşımak için kullanılan ELT(Extract, Load ve Tranform) mimarisine sahip oracle tool'dur.


    Soru   2  :ODI'da model ne anlama gelmektedir.
    Cevap 2 :Data model, data server'da store edilmiş tablo veri yapısı grubuna karşılık gelmektedir. ODI topology sekmesinde tanımlanmış mantıksal bir şemaya dayanmaktadır ve sadece metadata bilgisini içermektedir.


    Soru   3 :ODI'daki repository tipleri nelerdir
    Cevap 3 :ODI'da 2 tip repository mevcuttur.

    • Master repository: Kurum yada kuruluşlar hakkında bilgilerinin tutulduğu  repository'dir. Şirketin IT kaynakları, güvenlik bildirimleri, veri modeli ve versiyonlama bilgileri tutulur.
    • Work Repository: Data model ve project'ler üzerinde bulunana bilgileri içeren bir veri yapısıdır. Repository ilişkisel bir veritabanı üzerinde depolanır. Bir master repository üzerinde birden fazla work repository oluşturulabilir ama bir work repository birden fazla master repository ile ilişkili olamaz. 
    Repository'i oracle veritabanı düşündüğümüzde aslında bir şemadır. Bu şema altında ODI repository'leri kurulduğunda kendisinin kayıt atacağı tabloları oluşturur.


    Soru     4 : ODI'da kaç tip variable var?
    Cevap  4 : Global ve project olmak üzere 2 tip variable vardır.

       Variable, ODI'da tek bir değeri depolayan bir object'dir. Bu değer string, number ve date olabilir. Bu variable, değeri  bir mantıksal şema üzerinde çalıştırılan sorgu sonucuna göre update olabilir. Örnek olarak database'den mevcut tarihi ve saati alabilir. Bir variable global olarak veya project içinde oluşturulabilir. Global variable tüm proje'lerde kullanılabilir ama project variable sadece oluşturulduğu projede kullanılabilir.


    Soru    5 :Variable'lar nerde kullanılır?
    Cevap 5 :Variable'lar tüm oracle data integrator expression'larında kullanılabilir. 
    • Mapping
    • Filters
    • Joins
    • Constraint
    Soru    6 :Oracle Data Integrator'da package nedir?
    Cevap 6 : Package, ODI'daki en büyük execution unit'tir yani bir package ile birden fazla işi tek seferde execute edilebilir Örnek olarak birden fazla mapping'i tek bir package'te aynı anda execut etme.


    Soru    7 : Load Plan nedir ve kaç tip load plan vardır?
    Cevap 7 : Load plan,  oluşturduğun scenario'ların execution'larını sırayla, paralel veya koşula bağlı olarak bir çok scenario'yu execute etmek veya çalıştırmak için bir process'tir.


    Soru     8 : ODI'da log level tipleri nelerdir ?
    Cevap  8 : Notification, error, warning, trace vb. 

    Soru     9 : ODI'da I$,  E$,  J$  ve C$ tabloları nedir?
    Cevap  9 : 
    • E$: ODI tarafından oluşturulan geçici bir hata tablosudur. Check Knowledge Module(CKM), tarafında oluşturulur. CKM'e takılan kayıtlar bu tabloya insert edilir.
    • J$: Tüm değişikliklerin kaydedildiği tablodur. Değişilik tipi(insert,update,delete) ile beraber değiştirilen kayıtları tutar Journalizing Knowledge Module tarafında oluşturulur. 
    • I$: Integration Knowledge Module(IKM) tarafında oluturulur. LKM,veriyi C$ tablosuna yükledikten sonra IKM, I$ tablosuna yükler.
    • C$:Loading Knowledge Module(LKM) tarafında staging area'da oluşturulur. Source'dan yüklenecek verileri geçici olarak tutar. 

    Soru    10 :Knowledge Module tipleri nelerdir?
    Cevap 10 : 
    • Reverse Enginering Knowledge Module (RKM):Bu modül, Source database'den tablo ve diğer objelerin metada bilgilerini okumak için kullanılır. 

    • Loading Knowledge Module (LKM): Source database'deki verileri,  staging area'ya yüklemek için kullanılır.
    • Integration(Load) Knowlege Module (IKM): Staging area'daki verileri target tablolara yüklemek için kullanılır.
    • Check Knowledge Module (CKM): Veri tutarlılığını kontrol etmek için kullanılır. 

    • Journalizing Knowledge Module (JKM):Değişikliği takip etmek için source database'den  veri değişikliklerinin(update, delete,insert) günlüğünü oluşturmak için kullanılır.


    Soru     11 : ODI Console nedir?
    Cevap  11 : Browser üzerinde designer, operator ve topology component'lerine erişmek için kullanılan web tabanlı bir navigator.


    Soru    12: ODI'daki component'ler nelerdir ve ne için kullanılır
    Cevap 12:

    • Designer  :Development
    • Operator  :Monitoring
    • Topology :Configuring
    • Security   :Provide security

    Soru    13 : Physical Schema, Logical Schema ve Context arasındaki ilişki nedir.
    Cevap 13 : Bu 3 kavramdan biri olmadan diğeri olmaz.


    Data Server: Database bağlantısını tanımlayan object'tir. Database instance'ı için user, password ve ip bilgisini depolar.

    Physcial Schema: 2 database schema'sı(Oracle tanımında) tanımlanır. Bu schema'lardan biri data'yı diğeri ise ODI işleri(I$ ve C$ tablolarının bulundüğu çalışma alanı) okumak için.

    Context : Bir enviroment(örnek prod, dev, test gibi) tanımlar. Kodu execute etmek için özel bir alan.

    Logical Schema: Logical bir yapı için bir alias'tır.


    Soru    14 : ODI'da scenario nedir?
    Cevap 14 : Bir package, mapping, variable veya procedure component'i bittiği zaman bir scenario'da derlenir.  Scenario, production için execution etme birimidir. scenario schedule edilebilir.

    25 Aralık 2016 Pazar

    İş Zekasına Genel bir Bakış


    Merhaba arkadaşlar,

    Aşağıdaki slaytta iş zekasının genel olarak anlatımı mevcuttur umarım faydalı olur.


    29 Ekim 2016 Cumartesi

    Oracle Database Architecture(Database Storage Structure)

    Database Storage Structure

    Veritabanının önemli görevlerinden biri veriyi depolamaktır(storage). Bu başlıkta oracle database'de kullanılan fiziksel ve mantıksal depolama yapılarından bahsedilecektir.


    1 Pyhsical Storage Structures

    Fiziksel database yapısı veriyi depolayan dosyalardır. Create database" ifadesi excute edildiğinde aşağıdaki file'lar oluşur.

    • Data Files:Her oracle database'i bir veya birden fazl data file'lara sahiptir. Bu data file'lar database'deki tümverileri içerir. Tablo ve Index gibi mantıksal veritabanında bulunan veriler fiziksel olarak data file'larda depolanır.

    • Control File:Her oracle database'i bir control file'a sahiptir.Control file'lar database'in fiziksel yapısında belirtilen tüm metadata bilgilerini içerir. Bu meta bilgileri arasında database adı, database dosyalarının bulunduğu dizin(location)

    • Online Redo Log FilesHer oracle database'i bir online redo log'a sahiptir. Online redo log, 2 veya 2 den fazla online redo log file'lardan oluşmaktadır. Redo log file'lar, veride yapılan tüm değişiklikleri kaydeder. En az iki redo log file olmasının sebebi ise bir tanesini kullanılırken diğerinin arşive çıkabilmesidir. Böylece her zaman çalışılabilir olmayı sağlar. Veri güvenliği için her bir değişiklik online redo log diye isimlendirilen dosya'lara yazılır.

    • Parameter Files:Database ve database'in instance'ının configuration  parametrelerinin listesini içeren dosyadır.

    • Archived Redo Log:Oracle database tarafından arşivlenen online redo log kaydını içerir. Database recovery için kullanılır.

    • Trace Files and Alert Log:Oracle instance'ı çalışırken bir hata oluşursa mesajlar alert dosyasına kronolojik olarak yazılır. Database açılırken eğer bir alert dosyası yoksa oracle bir tane oluşturur. Eğer hata background process'lerde tespit edildiyse bilgi, trace file'a yazılır.
    • Flashback Log:
    • Backup Files:

     2 Logical Storage Structure

    • Data Block:Mantıksal olarak database verilerin saklandığı en küçük birimdir. Oracle database verileri  data block'larda depolar. Bir data block disk üzerinde bulunan belirli bir byte'a karşılık gelmektedir.
    • Extent:Bir extent, belirli sayıdaki data block'ların bir araya gelmesiyle tek bir alanı ifade eder. Belirli bir bilgi tipini depolamak için kullanılır. 
    • Segment:Bir segment, kullanıcı nesnesi için ayrılan extentler kümesidir. Örnek olarak tablo, index. Aşağıdaki şekilde data block, extent ve segment'ler arasındaki ilişki gösterilmektedir.

    • TableSpace:Bir database tablespace olarak adlandırılan mantıksal depolama birimlerine ayrılır. Bir tablespace, segment'leri içeren mantıksal bir kapsüldür. Her bir tablespace fiziksel olarak en az bir data file içerir.


    Oracle Database Architecture(Database Instance Structure)

    Database Instance Structure

           User'lar, database erişmek ve yönetmek için bellek yapıları(SGA,PGA) ve process'leri(client server, background server) kullanır. Bir database application(Örneğin Toad, Sql Developer), oracle database'e bağlandığı zaman aslında database'e direk bağlanmayıp, o database'in instance'ına bağlanmaktadır. Database instance, diğer bellek alanları ve ek olarak SGA'yı ayırarak uygulamalara hizmet eder ve diğer process'leri ve ek olarak background process'leri başlatır.

    Oracle Database Process

    Process, işletim sisteminde step'leri seri olarak çalıştıran bir mekanizmadır. Oracle database aşağıdaki process tiplerine sahiptir.
    • Client Process:Bir oracle tool'u veya bir uygulama programı yazılım kodunu çalıştırmak için oluşturulur ve sürdürülür.
    • Server Process:Request'leri yerine getirmek için  client process ile iletişim kurar ve oracle database ile etkileşim halindedir.
    • Background Process:Background process'leri fonksiyonları konsolide eder. aksi halde her bir client için bir çok database programı çalıştırılarak request yerine getirilir.

     Database Writer(DBWn):Database buffer cache'te değişen data block'larn data file'lara yazar.


    Log Writer(LGWr):Database'de değişikliğe neden olan DML komutların redo log buffer'dan redo log file'lara yazar.


    CheckPoint Process(CKPT):Buffer cache'deki değişiklikleri database'e kaydedildiğinde database durum bilgisini günceller.


    System Monitor(SMON):Database açıldğında recovery gerekip gerekmediğini araştırır.Database tutarlılığıını kontrol eder.
                 
    Process Monitor(PMON):Process'lerden biri sonlanmazsa bu process'in kullandığı tüm kaynakları temizler.

    Instance Memory Structures

    Oracle database, user'lar arasında veri paylaşmak için bellek yapıları oluşturur ve kullanır. Bu bellek yapıları aşağıda ifade edilmektedir.

    System Global Area(SGA)

    SGA bir database instaqnce için kontrol bilgileri ve verileri içeren paylaşılmış bellek yapıları grubudur. SGA component'lerine örnek olarak database buffer cache ve shared sql area verilebilir.

    Program Global Area(PGA)

    PGA, server ve background process için kontrol bilgileri ve verileri içeren bir bellek(memory) alanıdır. PGA'ya erişim process'e özeldir. Her bir server ve background process için kendisine ait PGA'ya sahiptir.

    28 Ekim 2016 Cuma

    Oracle Database Architecture(Database and Database Instance)

    Database and Database Instance


    1.1 Database: Disk üzerine konumlandırılan  dosyalar kümesidir. Veriyi depolar. Disk üzerindeki dosyalar, bir database instance’ından bağımsız olarak oluşurlar.

    1.2 Database Instance:Veritabanı dosyalarını yöneten bellek yapıları(SGA, PGA) kümesidir. Instance’lar SGA olarak adlandırılan paylaşılmış bellek alanlarından ve background process’lerden  oluşurlar. Bir Instance,  veritabanı dosyalarından bağımsız olarak oluşabilir. Database instance start edildiğinde SGA olarak adlandırılan bir bellek alanı ayırır. Bir user database instance üzerinden database'e erişebilir.


    Database Instance aşağıda belirlilen birbirinden ayrı 2 yapıda yapılandırılabilir.
    • Single Instance Configuration:
              Database ve database instance arasında bire bir ilişkiyi ifade eder.
    • Oracle Real Application Cluster
             Database ve database instance arasında bire n ilişkiyi ifade eder.


    SGA(System Global Area): Bir Oracle Instance'a atanan paylaşılmış bellek alanı grubudur. Tüm oracle process'leri bilgileri tutmak için SGA'yı kullanır. SGA, database'den gelen verileri  ve database'in ihtiyaç duyulan internal kontrol bilgilerini depolamak için kullanılır. SGA'da bulunan veriler tüm database kullanıcılarının paylaşımına açıktır. Bazı oracle initialization parametreleri(db_cache_size, shared_pool_size,log_buffer) ayarlanarak SGA'ya ayrılacak(allocated) bellek miktarı kontrol edilebilir. 


    SGA(System Global Area) Neler Yapar

    • Disk'ten okunan data block'larını cache'ler.
    • Sql Execution Plan'larını depolar.
    • Redo data'larını, online redo log file'lara yazmadan önce ara belleğe alır.
    • Aynı anda bir çok process ve threat'ler tarafından erişilen internal verileri maintain eder.
    SGA Üzerinde Bulunan Componentler
    • Database Buffer Cache(Buffer Cache):Sql işlemlerini gerçekleştirmek için data file'lardan okunan data ve index block'larının copy'lerini depolayan bellek alanlarıdır. Böylece data'lara daha hızlı erişim sağlanır. Buffer cache'deki bir block aşağıda belirtilen 3 durumdan biri olabilir.               
                                 Free Block:Şuanda hiç bir durum için kullanılmayan block
                                 Pinned Block:Şuanda erişilen block 
                                 Dirty Block:Değiştirilmiş ama henüz disk'e yazılmayan block


    • Redo Log Buffer:Instance'ın database'de yaptığı değişikliklerin kaydedildiği alandır. Gerektiğinde recovery işlemlerinde kullanılmak üzere bu bilgiler belirli aralıkta background process olan LGWR tarafından disk üzerindeki online redo log file'lara aktarılır.

    • Shared Pool:SGA üzerinde, database buffer cache'ten sonra en önemli componenttir. Shared Pool, library cache, dictionary cache ve result cache'i içerir
                                Library cache:Herhangi bir sql sorgusu çalıştırıldığında sorgu parse edilir ve                                       sorgunun execution'ı planı oluşturulur.Bu plan hangi tabloada hangi indexler nereye                             bağlantılı yapıldı, costu ne gibi bir takım özellikler barındırır. Bir sorgu çalıştırıldığı                             zaman execution plan bu alanda tutulur.Bu bellek alanı en son executed edilen sql                                 ve plsql ifadeleri cache'ler. Shared sql area ve private sql area'yı içerir.Shared sql                                   area tüm user'ların erişebildiği alandır. private sql area sadece user'ın  erişebildiği                                 alandır.
                      
                                Dictionary cache:En son kullanılan veri tanımlamaları depolamak için                                                                               kullanılır. Bu veri tanımlamaları, database files, table,                                                                             index,priviliges, users hakkında verileri içerir. Bellekte bu bilgiyi                                                           cache'lemek özellikle  query ve update için performansı artırır.

                                Result cache:Sql sorgu sonuçlarını ve plsql sorgu sonuçlarını cache'ler.
                             
    • Large Pool:Backup/Recovery işlemleri ve I/O işlemleri gibi bazı büyük işlemler    için büyük  miktarda bellek tahsisi gerektiğinde kullanılan bellek alanıdır.
    • Java Pool:Java Sanal Makines(JVM) tarafında kullanılan tüm oturum-bazlı  java  kodu verisini saklar.
    • Stream Pool:Capture ve apply işlemleri için gerekli olan bilgileri saklamak için oracle stream tarafından kullanılır.
    Database Instance'nına her bir kullanıcı bağlantısı için client process uygulama çalıştırır. Her bir client process kendi server process'i ile ilişkilidir. Server process, Program Global Area(PGA) olarak bilinen kendine özel bir session memory'e sahiptir.

    Program Global Area(PGA): Bellekteki server process için veri ve kontrol bilgilerini içeren  bellek alanıdır. 

    PGA aşağıdaki bilgileri içerir. 

    Sort Area: Sql process ile  gerekli herhangi bir sort için kullanılır.
    Session Information: Kullanıcı yetkilerini içerir.
    Curse State: Sql process aşamasını belirtir.
    Stack Space:Session variable'larını içerir.


    16 Ekim 2016 Pazar

    IBM Cognos Dynamic Cube Lifecycle


    • IBM Cube Designer: Geçmişteki başarılı modelleme teknolojilerinden faydalanarak en iyi modelleme prensiplerini bir araya getiren bir modelleme tool'udur. Cognos dynamic cube'i deploy etmenin ilk adımı  Cognos Cube Designer ile modellenmesidir.  Modellenen cube publish edildikten sonra, content managager'a kaydedilir. IBM Cognos dynamic cube server, content manager'dan cube'i okur.
    • IBM Cognos Dynamic Cubes server: Bir dynamic cube tasarlanıp ve deploy edildikten sonra,  Cognos ortamında available(kullanılabilir durumda) olur ve dynamic cube uygulaması için arayüz katmanında bir data source olarak davranır. 
    • Aggragate Advisor (IBM Cognos Dynamic Query Analyzer):Bir dynamic cube BI ortama deploy edildikten sonra raporlama ve analitik için kullanılabilir(available) durumda olur. Server, sistemin nasıl kullanıldığını anlamak için log'lar tutar ve aggregates'leri optimize etmek yani hem in-memory hemde in-database aggregate'ler için bu log'ları kullanabilir.

     Aggregate'ler oluşturmak için Dynamic Query Analyzer (DQA) yükleyerek aggregate adviser'u kullanılabilir. DQA, Cognos Dynamic Cubes ve Dynamics Query için en iyi performansı elde etmene yardımcı olan diagnostic(tanı) bir tool'dur.  Aggregate Advisor, cube tanımlamaları ve kullandığı tüm logları scan eder ve Cube'in performansını arıtırmak için aggregates'ler önerir. Bu yaklaşım belirli performans sorunlarını çözmeye yardımcı olur.


    Dynamic cubes,  Query service JVM içinde bulunan  in-memory olap kapsüllerdir.


    Aşağıdaki şekilde Dynamic cube'in  nasıl başlatıldığı, nasıl available  olduğu ve nasıl in-memory aggregates'leri load etmeye başladığı gösterilmektedir.